← zpět na projekty← back to projects
command-deck: řídicí centrum pro AI agentycommand-deck: a control centre for AI agents
Co to jeWhat it is
command-deck je moje osobní řídicí centrum pro vývoj s AI agenty. Spravuje nápady, nechá je prozkoumat v kódu i na webu a vyptává se mě, dokud z nápadu není úkol s hotovou specifikací. Pak úkol provede celým kolečkem: implementace, automatické kontroly, review, opravy a pull request. O sloučení rozhoduji já.command-deck is my personal control centre for building software with AI agents. It manages ideas, has them researched in code and online, and questions me until an idea becomes a task with a complete spec. Then it takes the task through the whole loop: implementation, automated checks, review, fixes and a pull request. I decide on the merge.
Nejde o jednoho agenta, ale o vrstvu nad několika. Mluvím s orchestrátorem, což je relace Claude Code, a on přes command-deck řídí ostatní: Codex, Claude Code, Devin a Gemini v Antigravity jako implementátory a recenzenty, další modely pro dohled a rady.It isn't one agent but a layer over several. I talk to the orchestrator, a Claude Code session, and it uses command-deck to run the others: Codex, Claude Code, Devin and Gemini in Antigravity as implementers and reviewers, and other models for monitoring and advice.
Hlavní uživatel nástroje je Harrowgate. Mezi 24. zářím a 16. říjnem 2026 prošlo command-deckem 112 úkolů hry až do sloučeného pull requestu.Its main user is Harrowgate. Between 24 September and 16 October 2026, 112 of the game's tasks went through command-deck all the way to a merged pull request.
Proč druhá verzeWhy a second version
První verzi jsem postavil v polovině září 2026. Byla to „softwarová továrna“: kanban aplikace v Reactu se serverem nad SQLite, navržená podle architektury od Gemini. Byla slabá. Za týden měla 112 commitů a zelené testy, ale celou cestu do sloučeného pull requestu zvládla jen u jednoho úkolu.I built the first version in mid-September 2026. It was a "software factory": a React kanban app with a server on SQLite, designed from an architecture by Gemini. It was weak. In a week it had 112 commits and green tests, but only one task made it all the way to a merged pull request.
24. září jsem udělal audit:On 24 September I audited it:
- Obrácená architektura. Mozkem byl server s kanbanem, ne agent. Když selhal volaný nástroj, systém si odpověď „dopočítal“ z výsledků vyhledávání.Inverted architecture. The kanban server was the brain, not the agent. When the tool it called failed, the system "filled in" an answer from search results.
- Bobtnání. Zhruba 36 tisíc řádků TypeScriptu a 13 migrací databáze, z nichž některé jen opravovaly předchozí.Bloat. About 36,000 lines of TypeScript and 13 database migrations, some of which only repaired earlier ones.
- Chyběly klíčové věci: chat s orchestrátorem, stránka se všemi otázkami najednou a automatická smyčka review → oprava.Missing core features: chat with the orchestrator, one page with all the questions, and an automatic review → fix loop.
- Testy, které nic netestovaly. Část jen ověřovala, že pravda je pravda.Tests that tested nothing. Some only checked that true is true.
Chyb bylo tolik, že bylo levnější začít znovu, než původní továrnu slepovat. Druhou verzi jsem začal od nuly ještě tu noc a první úkol pro Harrowgate jí prošel až do sloučení týž den.There were so many errors that starting over was cheaper than patching the old factory. I started the second version from scratch that same night, and the first Harrowgate task went all the way to a merge the same day.
Jak úkol projde od nápadu ke sloučeníHow a task goes from idea to merge
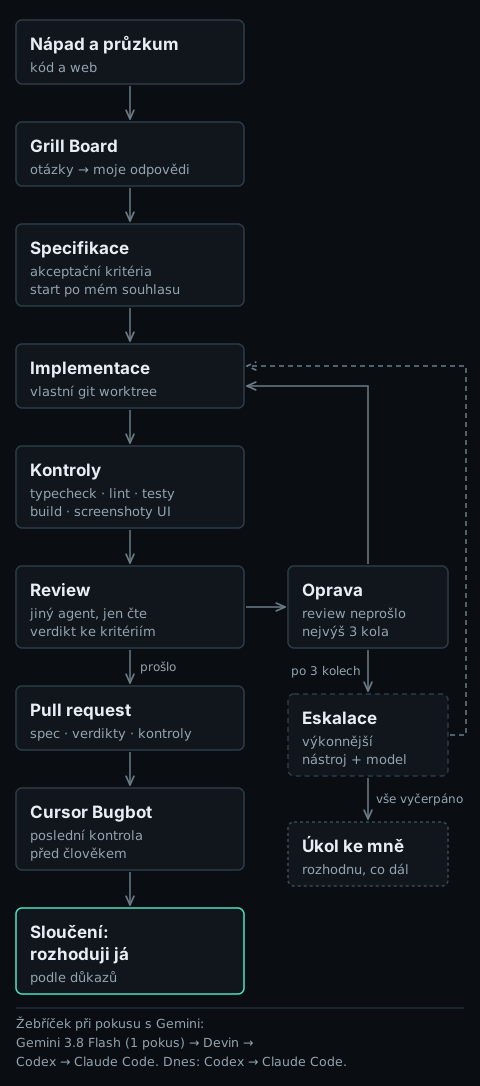
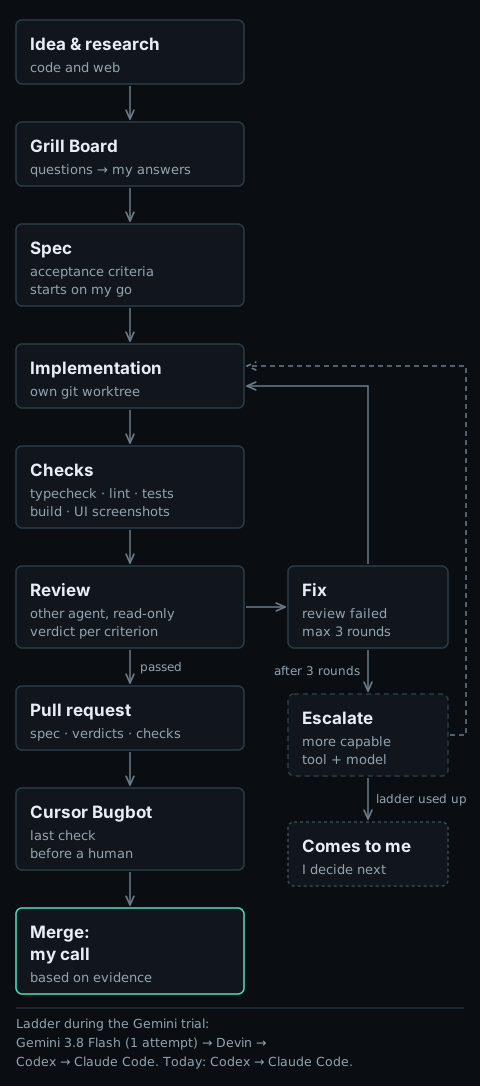
- Nápad a průzkum. Napíšu orchestrátorovi nápad česky. Založí úkol a projde kód i web.Idea and research. I describe the idea to the orchestrator in Czech. It creates a task and explores the code and the web.
- Grill Board. Otázky ke všem rozpracovaným nápadům jsou na jedné stránce. U každé je doporučená odpověď a vždycky můžu napsat vlastní. Úkol postoupí dál, až když jsou zodpovězené všechny otázky. Tenhle krok za mě neudělá ani orchestrátor.Grill Board. Questions for every open idea sit on one page. Each has a recommended answer, and I can always write my own. A task moves on only once every question is answered. Not even the orchestrator can do this step for me.
- Specifikace. Orchestrátor z odpovědí napíše specifikaci s očíslovanými akceptačními kritérii. Implementace se spustí, až když řeknu.Spec. The orchestrator turns the answers into a spec with numbered acceptance criteria. Implementation starts only when I say so.
- Implementace. Každý běh má vlastní git worktree, takže paralelní agenti si nesahají do práce.Implementation. Every run gets its own git worktree, so parallel agents stay out of each other's work.
- Kontroly. Proběhnou příkazy daného repozitáře, u Harrowgate typová kontrola, lint, testy, kontrola mrtvého kódu a build. Úkoly, které mění UI, musí navíc dodat screenshoty z prohlížeče.Checks. The repo's own commands run: for Harrowgate, typecheck, lint, tests, a dead-code check and the build. Tasks that change the UI must also deliver browser screenshots.
- Review. Kód kontroluje jiný agent, nebo aspoň jiný model, než který ho psal. Recenzent hodnotí každé akceptační kritérium s důkazem a odpovídá ještě na otázku: „Je tohle to, co se chtělo?“Review. The code is reviewed by a different agent, or at least a different model, than the one that wrote it. The reviewer rates every acceptance criterion with evidence and answers one more question: "Is this what was asked for?"
- Oprava. Když review neprojde, nálezy jdou zpátky implementátorovi. Jedna kombinace nástroje a modelu má nejvýš tři kola.Fix. If the review fails, the findings go back to the implementer. One tool-and-model combination gets at most three rounds.
- Eskalace. Když neprojde ani poslední kolo nebo agent dvakrát spadne, úkol automaticky přejde na výkonnější kombinaci a ta začíná s plným počtem kol. Když dojdou všechny stupně, úkol skončí u mě.Escalation. If the last round fails too, or the agent crashes twice, the task automatically moves to a more capable combination, which starts with a full set of rounds. When every step of the ladder is used up, the task comes to me.
- Pull request a sloučení. Úspěšný běh otevře pull request se specifikací, verdikty a výsledky kontrol. Na otevřený pull request se pak podívá Cursor Bugbot, moje poslední kontrola před člověkem. Bez jeho zelené kontroly nejde pull request sloučit. Bugbot není součástí decku a přidal jsem ho až později, ale osvědčil se. Sloučení je na mně. Rozhoduji podle důkazů: screenshotů, videí a ověření, že kód opravdu funguje.Pull request and merge. A passing run opens a pull request with the spec, the verdicts and the check results. Once the pull request is open, Cursor Bugbot reviews it as my last check before a human. Its check has to pass before the pull request can be merged. Bugbot is not part of the deck and I added it later, but it has proven itself. The merge is my call. I decide based on evidence: screenshots, videos and proof that the code actually works.
Kdo co děláWho does what
- Orchestrátor (Claude Code): mluví se mnou česky, píše specifikace, spouští běhy a hlídá frontu. Otázky, specifikace, kód i commity jsou anglicky.Orchestrator (Claude Code): talks to me in Czech, writes specs, starts runs and watches the queue. Questions, specs, code and commits are in English.
- Implementátoři na žebříčku eskalace. Každá kombinace nástroje a modelu má vlastní pravidla. Při pokusu s Gemini začínal každý úkol na Gemini 3.8 Flash v Antigravity a ten měl jediný pokus. Když neprošel kontrolami nebo review, jeho práce se celá zahodila a Devin začal od čistého základu, jen s nálezy jako varováním. Po Devinovi následoval Codex, po něm Claude Code. Dnes je žebříček kratší: Codex, pak Claude Code.Implementers on the escalation ladder. Every tool-and-model combination has its own rules. During the Gemini trial, every task started on Gemini 3.8 Flash in Antigravity, which got a single attempt. If it failed the checks or the review, its work was thrown away entirely and Devin started from a clean base, with the findings only as warnings. After Devin came Codex, then Claude Code. Today the ladder is shorter: Codex, then Claude Code.
- Recenzent: vždy jiný agent, nebo stejný nástroj s jiným modelem. Má přístup jen pro čtení, vynucený nastavením nástroje, ne jen promptem.Reviewer: always a different agent, or the same tool with a different model. It gets read-only access, enforced by the tool's settings, not just the prompt.
- Dohled: každých 20 minut levný model zkontroluje běžící implementaci a upozorní, když se agent zacyklí nebo odbočí od zadání.Monitor: every 20 minutes a cheap model checks a running implementation and flags an agent that's looping or drifting off the spec.
- Architekt: silnější model, kterého se deck ptal na radu u těžkých úkolů nebo po dvou neúspěšných kolech. Jen radil, a protože šlo o měřený pokus, statistiky porovnávaly úkoly s jeho radou a bez ní. Teď je vypnutý.Architect: a stronger model the deck consulted on hard tasks or after two failed rounds. It only advised, and since it was a measured trial, the stats compared tasks with and without its advice. It's switched off now.
PojistkySafeguards
U agentů, kteří pracují bez dozoru, nestačí je slušně požádat:With agents working unattended, asking nicely isn't enough:
- Pravidla v každém promptu: nesahat na přihlašovací údaje, tokeny a profily prohlížeče, nikam se nepřihlašovat, nedávat do repozitáře osobní data a zůstat ve svém worktree.Rules in every prompt: don't touch credentials, tokens or browser profiles, don't log in anywhere, don't put personal data in the repo, and stay inside your worktree.
- Review: recenzent kontroluje diff proti stejným pravidlům a každé porušení je blokující nález.Review: the reviewer checks the diff against the same rules, and every violation is a blocking finding.
- Kontrola před pushem: deck hledá v přidaných řádcích e‑maily, domovské cesty a běžné formáty tokenů a klíčů. Nález zablokuje push.Pre-push scan: the deck scans added lines for email addresses, home paths and common token and key formats. A hit blocks the push.
- Lokální server je jen lokální: dashboard poslouchá jen na mém počítači a odmítá požadavky z cizích webů, včetně útoku přes DNS rebinding.The local server stays local: the dashboard listens only on my machine and rejects requests from other websites, including DNS-rebinding attacks.
- Nastavené limity: celý systém se drží limitů, které nastavím: kolik agentů smí běžet najednou a kdy, kolik kol a konzultací úkol dostane a jak dlouho smí běžet kontroly. Když potřebuji počítač, řeknu „do šesti jen jeden agent“ a rozběhnutá práce doběhne.Configured limits: the whole system respects the limits I set: how many agents may run at once and when, how many rounds and consultations a task gets, and how long checks may run. When I need my PC, I say "one agent until six" and the running work finishes.
Měřím, co fungujeMeasuring what works
Ve statistikách decku vidím po dnech, týdnech i měsících, který nástroj spotřeboval kolik tokenů a na kterém projektu, rozdělené na vstup, výstup a čtení z cache. Vidím taky, kolik kol který agent potřeboval k úspěšnému review a jak často se od něj eskalovalo, tedy kdo selhával víc a kdo míň.The deck's stats show me, by day, week and month, how many tokens each tool used and on which project, split into input, output and cache reads. They also show how many rounds each agent needed to pass review and how often it was escalated away from, so I can see who failed more and who failed less.
Do stejných statistik jsem napojil experimenty:I wired my experiments into the same stats:
- Gemini jako první implementátor. Levný a rychlý Gemini 3.8 Flash dostal každý úkol jako první. Výkonnější model pak v review rozhodl, jestli jeho práce obstojí, nebo se zahodí a začne se znovu. Statistiky počítaly pokusy, úspěchy, důvody selhání, kolik review stály neúspěšné pokusy a jak rychle se úkoly dostaly ke sloučení ve srovnání s těmi, které rovnou začínaly Devinem.Gemini as the first implementer. The cheap, fast Gemini 3.8 Flash got every task first. A more capable model then decided in review whether its work held up or got thrown away for a fresh start. The stats counted attempts, passes, failure reasons, how many reviews the failed attempts cost, and how fast tasks reached a merge compared with tasks that started on Devin.
- Dá se spolehnout na SWE-2 při code review? Devin s modelem SWE-2 dělal stínová review souběžně s Codexem a dalšími recenzenty. Jeho verdikt nic neovlivňoval, jen se porovnával: shoda celkově, u jednotlivých kritérií a kterým směrem se verdikty lišily.Can SWE-2 be trusted with code review? Devin with the SWE-2 model ran shadow reviews alongside Codex and the other reviewers. Its verdict didn't affect anything; it was only compared: overall agreement, agreement per criterion, and which way the verdicts differed.
Deck se učí z vlastních chybThe deck learns from its own mistakes
Všechny nálezy z review se ukládají. Za dva týdny jich bylo 1 082 u 108 úkolů, nejčastěji šlo o testy (268), nesoulad se specifikací (262) a okrajové případy (193).Every review finding is stored. In two weeks there were 1,082 of them across 108 tasks, most often about tests (268), spec mismatches (262) and edge cases (193).
Zhruba po každých pěti sloučeních deck nálezy seskupí a ukáže, co se opakuje alespoň ve třech úkolech. Z toho vznikne návrh pravidla do nejlevnější vrstvy, která chybu zachytí: oprava v kódu, kontrola v CI, pravidlo pro agenty, nebo checklist v promptu. Bez mého schválení se nic nezapíše. První přijaté pravidlo zní: testy mají ověřovat záměr specifikace, ne fotit, co kód zrovna dělá. Po auditu testů Harrowgate přibylo dalších šest.About every five merges, the deck groups the findings and shows what recurs in at least three tasks. Each group becomes a proposed rule for the cheapest layer that would catch it: a code fix, a CI check, a rule for agents, or a prompt checklist item. Nothing gets written without my approval. The first accepted rule: tests must check the spec's intent, not snapshot whatever the code happens to do. After an audit of Harrowgate's tests, six more followed.
Co s ním vznikloWhat it built
Přes command-deck prošla velká část dnešního Harrowgate: 112 úkolů, každý jako jeden sloučený pull request, ve stejném období 112 ze 134 commitů v hlavní větvi hry. Mimo jiné:A large part of today's Harrowgate went through command-deck: 112 tasks, each one merged pull request, which in that period was 112 of the 134 commits on the game's main branch. Among them:
- dungeony pro hodnosti D až S a modely jejich monster a bossů,dungeons for ranks D to S and models for their monsters and bosses,
- zorné kužely, plížení a zapojování do boje ve skupinách,vision cones, stealth and group combat participation,
- přestavba města, strážce brány Ronald a deník úkolů,the town rework, Gatekeeper Ronald and the quest journal,
- runy, mistrovství, svatyně a pasti,runes, mastery, shrines and traps,
- opětovné připojení v multiplayeru, kontrola shody replayů a simulace balancu.multiplayer reconnect, replay-parity checks and balance simulations.
Deck taky postavil sám sebe. Kromě úvodní kostry prošlo 55 jeho vlastních úkolů stejnou cestou jako úkoly hry.The deck also built itself. Apart from the initial skeleton, 55 of its own tasks took the same path as the game's.
Stav a co dálStatus and next steps
command-deck je teď dočasně odstavený. Intenzivně jsem ho používal od konce září do poloviny října 2026. Teď si dávám měsíc až dva na průzkum podobných veřejně dostupných i placených nástrojů a knihoven skillů. Chci zjistit, co funguje líp, co jsem dělal dobře a co by šlo dělat jinak. Podle toho se k decku možná vrátím.command-deck is on hold for now. I used it heavily from late September to mid-October 2026. I'm now taking a month or two to research comparable public and paid tools and skill libraries. I want to find out what works better, what I did well and what could be done differently. Depending on that, I may come back to the deck.
Co to říká o tom, jak pracujiWhat it says about how I work
Nejdůležitější věc z první verze: víc kódu neznamená lepší nástroj. Druhá verze je menší a dělá to, co jsem opravdu potřeboval: nejdřív se mě vyptá na všechno podstatné, pustí práci do paralelních agentů a vrátí mi ji zkontrolovanou.The biggest lesson from the first version: more code doesn't make a better tool. The second version is smaller and does what I actually needed: it questions me, hands the work to parallel agents and gives it back reviewed.
Agentům věřím zhruba jako novému kolegovi. Mají jasné zadání a pravidla, jejich práci kontroluje někdo jiný a do ostrého prostředí nemají přístup. O tom, který agent na co stačí, nerozhoduji podle dojmu, ale podle čísel. A když se stejná chyba objeví potřetí, už ji neopravuji ručně. Udělám z ní pravidlo.I trust agents roughly the way I'd trust a new colleague. They get a clear brief and rules, someone else reviews their work, and they have no access to production. I don't judge which agent is good for what by gut feeling, but by the numbers. And when the same mistake shows up a third time, I stop fixing it by hand. I turn it into a rule.